Tausende KI-Agenten durchforsteten in 32 Minuten die Gehirndaten von Mäusen
OpenAI, PerturbAI und Scripps Research nutzten die Wirkstoffe GPT-Rosalind, um Millionen Gehirnzellen von Mäusen zu analysieren und neue Hinweise vorzuschlagen, die noch im Labor getestet werden müssen.
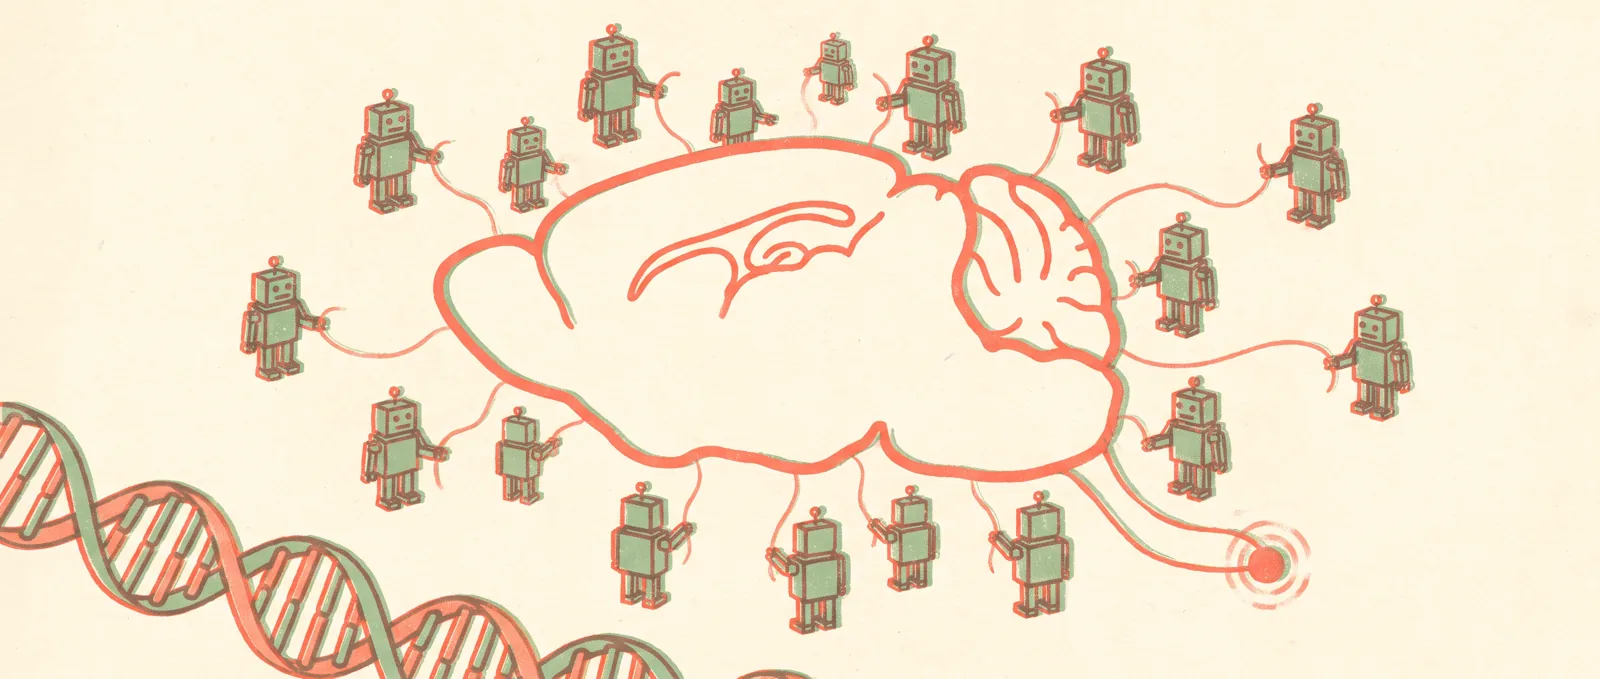
OpenAI, PerturbAI und Scripps Research berichten, dass Tausende von KI-Agenten, die auf dem GPT-Rosalind-Modell von OpenAI ausgeführt wurden, in 32 Minuten vorhandene Daten von Millionen von Mausgehirnzellen analysierten. Das Team sagt, dass eine vergleichbare menschliche Arbeit Monate bis ein Jahr dauern würde.
Die Methode heißt „verteiltes biologisches Denken“, was ein schicker Name für eine einfache Idee ist: die Aufgabe in viele kleine Teile aufzuteilen. Jeder Wirkstoff nahm eine einzelne Genstörung aus einem großen hirnweiten CRISPR-Atlas (ein Katalog dessen, was mit Zellen passiert, wenn ein Gen ausgeschaltet wird), untersuchte die Auswirkungen, durchsuchte die wissenschaftliche Literatur und schlug Erklärungen vor. Ihre Berichte wurden dann in einem „Argumentationsatlas“ zusammengeführt, der Gene, Wirkungen, Papiere und mögliche Mechanismen verknüpft. Nach Angaben des Teams reproduzierten die Agenten Erkenntnisse aus früheren menschlichen Analysen und fügten neue Hinweise hinzu. Blinde menschliche Experten bewerteten die Neuheit und den wissenschaftlichen Wert der Arbeit der Agenten ähnlich wie ihre eigene. Im Vergleich mit einem Agenten mit demselben Modell zitierte der Schwarm bei der höchsten Arbeitsbelastung über 700 Referenzen gegenüber 11, und Experten bevorzugten in 75 Prozent der Fälle die Berichte des Schwarms.
Zwei Beispiele weisen darauf hin: Die Störung des Gens Tsc2 veränderte viele neuronale Kommunikationsgene im Kleinhirn, während sich durch die Störung seines Partners Tsc1 kaum etwas änderte, was möglicherweise mit Kleinhirnproblemen bei Tuberkulose zusammenhängt. Und die Störung von DCTN1, die mit dem Perry-Syndrom in Verbindung steht, führte zu einer Erhöhung der Gene für die Cholesterinproduktion, was auf einen möglichen Weg zur Neurodegeneration hindeutet. Der Atlas befindet sich auf GitHub und das Papier auf bioRxiv.
Es lohnt sich, die Erwartungen auf dem Boden zu halten: Dies sind Hypothesen, keine Entdeckungen. Die Mechanismen müssen noch im Labor validiert werden, die Vergleiche sind eigene Auswertungen der Autoren und die Seite enthält nur begrenzte Details zu ihrer Durchführung.
Was dahintersteckt: Ein einzelner KI-Assistent arbeitet wie ein sehr schneller Forscher. Ein Schwarm funktioniert eher wie eine Abteilung, in der jedes Mitglied eine eng gefasste Frage erhält und die Antworten zusammengefasst werden. Das hilft am meisten, wenn zu einem Feld mehr Daten vorliegen, als die Leute Zeit zum Lesen haben, was einen Großteil der modernen Biologie beschreibt. Der Engpass verlagert sich dann von der Analyse auf die Auswahl, was im Labor getestet werden soll.
Was das für Sie bedeutet: Für die meisten Menschen ändert sich heute nichts. Aber es ist ein klares Bild davon, wohin sich „Agenten“ jenseits von Chatbots und Codierung bewegen: parallele Teams von KI-Helfern, die einen Berg an Material selektieren. Wenn Sie mit großen Text- oder Datenmengen arbeiten, lohnt es sich, das gleiche Muster, eine kleine Aufgabe pro Agent und einen Kombinationsschritt, im Auge zu behalten.
Quellen
Quellen: https://openai.com/index/scaling-ai-research-for-complex-biological-data/
Die Decisions API von OpenAI beantwortet schnelle Ja/Nein-Fragen für 0,10 $ pro Million Tokens
Der allgemein verfügbare Decisions API von OpenAI, der auf GPT-6 Luna aufbaut, gibt Wahrscheinlichkeiten für begrenzte Fragen wie Klassifizierung oder Routing zurück und berechnet keine Ausgabe Tokens.