Miles de agentes de IA revisaron datos del cerebro de un ratón en 32 minutos
OpenAI, PerturbAI y Scripps Research utilizaron agentes GPT-Rosalind para analizar millones de células cerebrales de ratón y proponer nuevas pistas, que aún necesitan pruebas de laboratorio.
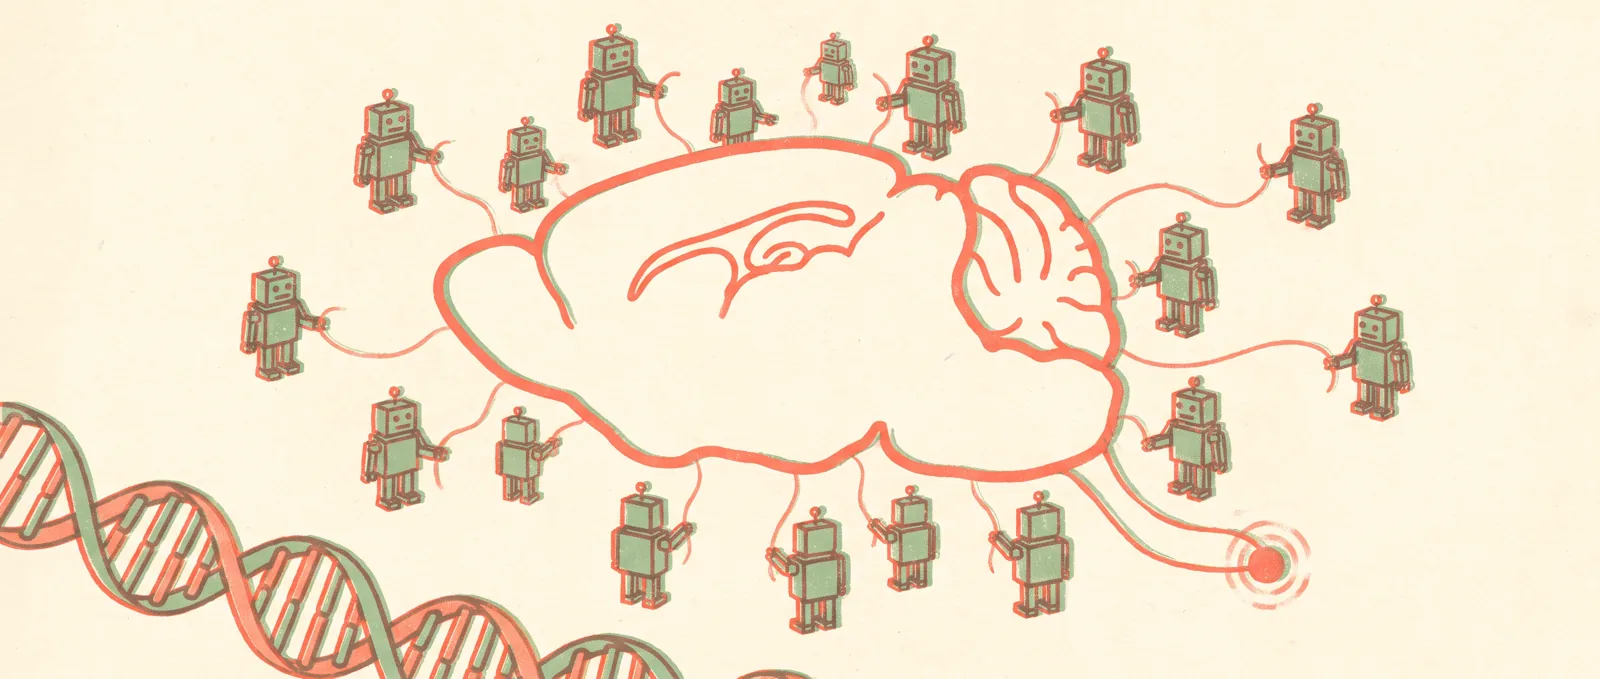
OpenAI, PerturbAI y Scripps Research informan que miles de agentes de IA, que se ejecutan en el modelo GPT-Rosalind de OpenAI, analizaron datos existentes de millones de células cerebrales de ratón en 32 minutos. El equipo dice que un trabajo humano comparable llevaría de meses a un año.
El método se llama “razonamiento biológico distribuido”, que es un nombre elegante para una idea simple: dividir el trabajo en muchas partes pequeñas. Cada agente tomó una única alteración genética de un gran atlas CRISPR de todo el cerebro (un catálogo de lo que les sucede a las células cuando se desactiva un gen), estudió los efectos, buscó en la literatura científica y propuso explicaciones. Luego, sus informes se fusionaron en un “atlas de razonamiento” que vincula genes, efectos, artículos y posibles mecanismos. Según el equipo, los agentes reprodujeron hallazgos de análisis humanos anteriores y agregaron nuevas pistas. Expertos humanos ciegos calificaron la novedad y el valor científico del trabajo de los agentes de manera similar al suyo. En una comparación con un agente al que se le dio el mismo modelo, el enjambre citó más de 700 referencias en la carga de trabajo más grande frente a 11, y los expertos prefirieron los informes del enjambre el 75 por ciento de las veces.
Dos ejemplos de pistas: la alteración del gen Tsc2 cambió muchos genes de comunicación neuronal en el cerebelo, mientras que la alteración de su compañero Tsc1 cambió poco, lo que puede estar relacionado con problemas cerebelosos en la esclerosis tuberosa. Y la alteración de DCTN1, vinculada al síndrome Perry, elevó los genes de producción de colesterol, lo que sugiere una posible ruta hacia la neurodegeneración. El atlas está en GitHub y el artículo está en bioRxiv.
Vale la pena mantener las expectativas fundadas: son hipótesis, no descubrimientos. Los mecanismos aún necesitan validación de laboratorio, las comparaciones son evaluaciones de los propios autores y la página brinda detalles limitados sobre cómo se ejecutaron.
Qué hay detrás de esto: un único asistente de IA funciona como un investigador muy rápido. Un enjambre funciona más como un departamento, donde cada miembro recibe una pregunta concreta y las respuestas se combinan. Eso ayuda más cuando un campo tiene más datos de los que la gente tiene tiempo de leer, lo que describe gran parte de la biología moderna. El cuello de botella pasa entonces del análisis a la elección de qué probar en el laboratorio.
Qué significa esto para ti: para la mayoría de las personas, nada cambia hoy. Pero es una imagen clara de hacia dónde se dirigen los “agentes” más allá de los chatbots y la codificación: equipos paralelos de ayudantes de IA que clasifican una montaña de material. Si trabaja con grandes cantidades de texto o datos, vale la pena tener en cuenta el mismo patrón, una pequeña tarea por agente y un paso combinado.
Fuentes
Fuentes: https://openai.com/index/scaling-ai-research-for-complex-biological-data/
La Decisions API de OpenAI responde preguntas rápidas de sí/no por $0,10 por millón de tokens
El Decisions API generalmente disponible de OpenAI, basado en GPT-6 Luna, devuelve probabilidades para preguntas limitadas como clasificación o enrutamiento, y no factura los tokens de salida.