Migliaia di agenti IA hanno analizzato i dati del cervello dei topi in 32 minuti
OpenAI, PerturbAI e Scripps Research hanno utilizzato gli agenti GPT-Rosalind per analizzare milioni di cellule cerebrali di topo e proporre nuovi indizi, che necessitano ancora di test di laboratorio.
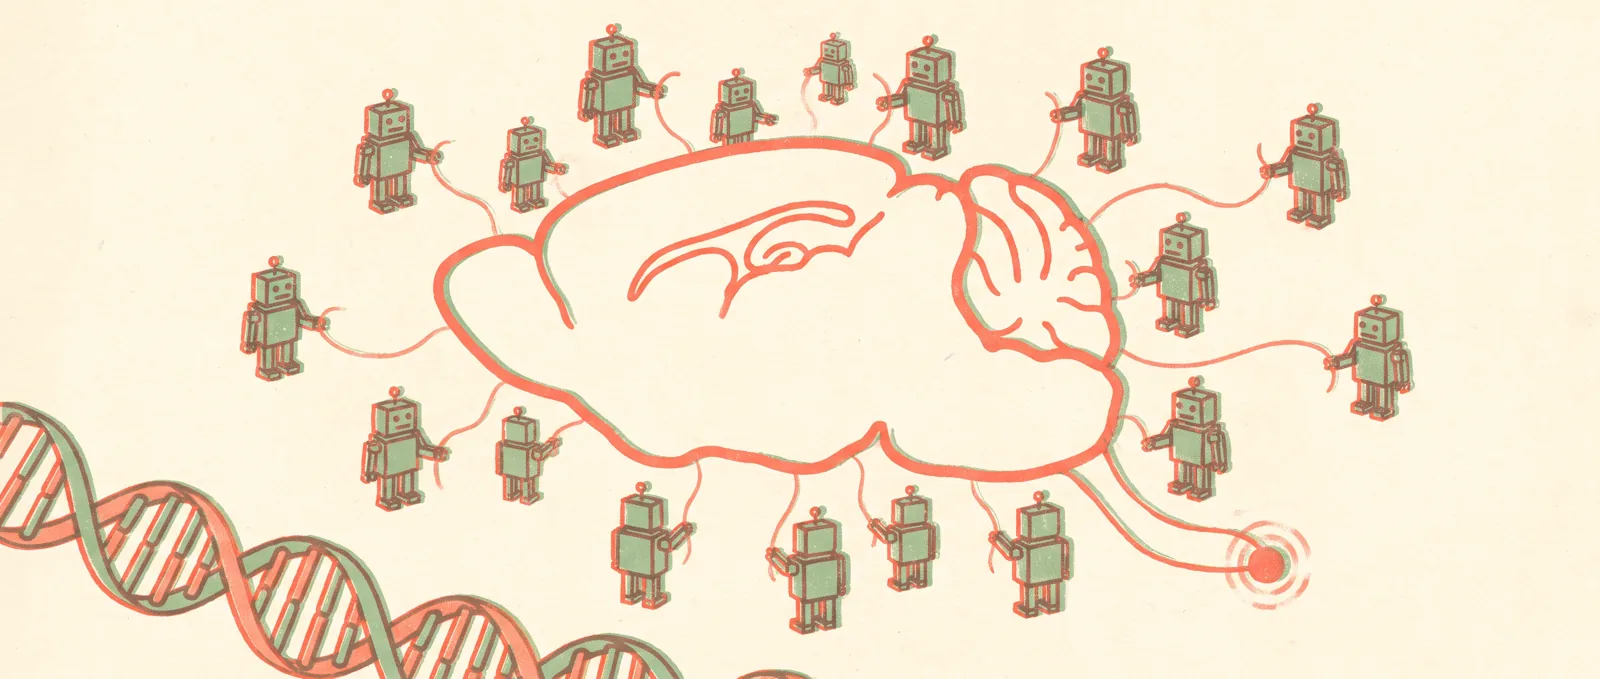
OpenAI, PerturbAI e Scripps Research riferiscono che migliaia di agenti IA, eseguiti sul modello GPT-Rosalind di OpenAI, hanno analizzato i dati esistenti di milioni di cellule cerebrali di topo in 32 minuti. Il team afferma che un lavoro umano comparabile richiederebbe da mesi a un anno.
Il metodo si chiama “ragionamento biologico distribuito”, che è un nome di fantasia per un’idea semplice: dividere il lavoro in tante piccole parti. Ciascun agente ha preso l’alterazione di un singolo gene da un grande atlante CRISPR (un catalogo di ciò che accade alle cellule quando un gene viene disattivato) esteso a tutto il cervello), ha studiato gli effetti, ha effettuato ricerche nella letteratura scientifica e ha proposto spiegazioni. I loro rapporti sono stati poi riuniti in un “atlante del ragionamento” che collegava geni, effetti, documenti e possibili meccanismi. Secondo il team, gli agenti hanno riprodotto i risultati di precedenti analisi umane e hanno aggiunto nuove piste. Esperti umani accecati valutarono la novità e il valore scientifico del lavoro degli agenti in modo simile al loro. In un confronto con un agente a cui è stato dato lo stesso modello, lo sciame ha citato oltre 700 referenze con il carico di lavoro maggiore rispetto a 11, e gli esperti hanno preferito i rapporti dello sciame il 75% delle volte.
Due esempi: l’interruzione del gene Tsc2 ha cambiato molti geni di comunicazione neuronale nel cervelletto, mentre l’interruzione del suo partner Tsc1 ha cambiato poco, il che potrebbe riguardare problemi cerebellari nella sclerosi tuberosa. E l’alterazione di DCTN1, collegata alla sindrome Perry, ha aumentato i geni che producono colesterolo, suggerendo una possibile via verso la neurodegenerazione. L’atlante è su GitHub e l’articolo su bioRxiv.
Vale la pena mantenere le aspettative radicate: queste sono ipotesi, non scoperte. I meccanismi necessitano ancora di validazione di laboratorio, i confronti sono valutazioni degli autori e la pagina fornisce dettagli limitati su come sono stati eseguiti.
Cosa c’è dietro: un singolo assistente AI funziona come un ricercatore molto veloce. Uno sciame funziona più come un dipartimento, in cui ogni membro riceve una domanda ristretta e le risposte vengono combinate. Ciò aiuta di più quando un campo contiene più dati di quanti le persone abbiano il tempo di leggere, il che descrive gran parte della biologia moderna. Il collo di bottiglia si sposta quindi dall’analisi alla scelta di cosa testare in laboratorio.
Che cosa significa per te: per la maggior parte delle persone, oggi non cambia nulla. Ma è un quadro chiaro di dove gli “agenti” si stanno dirigendo oltre i chatbot e la codifica: team paralleli di aiutanti di intelligenza artificiale che selezionano una montagna di materiale. Se lavori con grandi quantità di testo o dati, vale la pena tenere a mente lo stesso schema, una piccola attività per agente e una fase di combinazione.
Fonti
Fonti: https://openai.com/index/scaling-ai-research-for-complex-biological-data/
Decisions API di OpenAI risponde rapidamente a domande sì/no per $ 0,10 per milione di token
Decisions API generalmente disponibile di OpenAI, basato su GPT-6 Luna, restituisce probabilità per domande limitate come la classificazione o il routing e non fattura alcun token di output.